欢迎大家加入 GKD 大家庭!导航组表面上是在让机器人从一个位置走到另一个位置,实际上要同时处理传感器时间、坐标变换、状态估计、地图表达、路径搜索和底盘执行:机器人得知道自己在哪里、周围有什么,以及怎样在不确定性中安全地到达目标位置。
我该如何提问
- 学习的过程中难免会遇到困难,我们强烈建议充分使用 AI 工具 辅助学习。
- 请仔细阅读 提问的智慧 跟 别像弱智一样提问。遇到问题先尝试自己解决(当然,遇到无法解决的问题,也非常欢迎你们来提问,但请不要问 AI 可以轻松解答的问题)。
安装 Linux
请确保至少有一台安装了 Linux 或其他 Unix-like 操作系统,并能够稳定进行开发的设备。新手小白建议跟着教程安装 Ubuntu,尽量选择较新的版本。已经有相关经验的同学,如果能够自行解决依赖、环境等问题,且有能力驾驭,不影响开发,则不作此要求,使用其他操作系统也可以。
如果你的电脑已经安装了 Windows,可以选择安装 Windows 与 Linux 双系统。安装涉及磁盘分区和系统引导,操作不当可能导致原有 Windows 无法启动,甚至丢失数据,请不要跳过备份直接开始安装。
不推荐使用虚拟机!!! 虚拟机可以用来熟悉命令,但涉及仿真、图形界面和硬件通信时,经常会遇到性能、USB 和网络问题。
安装前,请将重要文件备份到外置硬盘或其他独立存储中,确认备份能够读取;如果 Windows 启用了 BitLocker 或设备加密,也请提前保存恢复密钥。分区时务必核对目标磁盘、分区大小和用途,保留原有 Windows 分区及系统引导、恢复分区,不要误选“擦除整个磁盘”,也不要格式化用途不明的分区。不同电脑的磁盘布局可能不同,教程中的分区编号不能直接照搬。如果看不懂当前操作会修改什么时,一定要先停下来找有经验的同学确认。
免责声明: 本文仅提供学习方向,不能替代针对你个人设备的安装指导。请在了解操作风险并完成备份后自行决定安装;因分区、格式化或引导配置等操作造成的数据丢失、原有系统损坏等后果,由操作者自行承担。
科学上网
请自行安装科学上网软件,需要能正常访问使用 Google、ChatGPT、Github、Wikipedia等网站。
学习 Python 和 C++
Python 与 C++ 是 ROS 2 开发的两大主流语言。尽管社区也提供了对其他语言的支持,我们仍强烈建议以 C++ 作为主要开发语言。即使在 AI 辅助开发日益普及的今天,真正理解代码依然是系统设计的第一步,也是技术选型与架构决策的根本前提。
以下是需要学习并掌握的编程基础的核心知识:
Python
基础部分
- 了解
int、float、bool、str、bytes、None,以及list、tuple、dict、set等数据类型的含义和常用方法 - 理解可变对象与不可变对象、切片、解包和浅拷贝与深拷贝。
- 理解
if-elif-else、for、for-else、while、break、continue、pass,以及条件表达式、match - 了解
range、enumerate、zip等常用内置函数 - 理解函数相关:位置参数、关键字参数、默认参数、可变参数
*args与**kwargs、返回值、作用域、递归、匿名函数lambda,以及类型标注和文档字符串。 - 理解 Python 的面向对象:
class、实例属性、类属性、方法、__init__、继承、组合、@property、@classmethod和@staticmethod;理解对象引用、生命周期和__repr__、__iter__等特殊方法
进阶部分(可选)
- 模块与工程:
import、包结构、__init__.py、__name__ == '__main__'、venv、pip、pyproject.toml,以及依赖版本管理。typing - 列表推导式、生成器与
yield、迭代器、装饰器、with、文件和 JSON 处理、logging、异常处理。 - 进程、线程、
asyncio、队列和锁
C++(含必要的 C 基础)
C 语言不一定作为 ROS 2 节点的主要开发语言,但它能帮助你理解指针、内存、结构体、数组和底层接口。C++ 在 ROS 2 的底层库、驱动和性能敏感节点中使用广泛,应当重点学习。
C++部分的学习,强烈建议参考:C++参考
基础部分
- 基础数据类型:
bool、char、short、int、long、long long、float、double、long double及对应的无符号类型;std::size_t、std::uint32_t等固定宽度整数类型, 了解enum class。 - 控制语句:
if、else、switch、case、default、for、范围for、while、do while、break、continue和return;同时理解条件表达式、逻辑运算和switch的适用场景。 - 函数:函数的声明与定义、值传递、指针传递、引用传递、默认参数、函数重载、
inline、std::function。 - 命名空间
namespace和using - C 风格数组与字符串、
std::array、std::string,以及基本的指针和引用用法。 - 面向对象:
class、struct、访问控制public/private/protected、构造函数、析构函数、普通成员函数、组合与继承。 - STL:了解容器,如
std::vector、std::deque、std::list、std::array、std::map、std::unordered_map、std::set、std::unordered_set和容器包装器,如std::queue、std::stack、std::priority_queue;掌握范围for、迭代器的基本使用,以及std::sort、std::find、std::lower_bound、std::accumulate等常用函数。 - 多线程:
std::thread、std::mutex、std::lock_guard、std::unique_lock、std::condition_variable和std::atomic;理解数据竞争、死锁、回调线程模型等。
进阶部分(可选)
虽然这部分是可选内容,但是这一部分的内容相当常用且重要。我们强烈建议各位慢慢过一遍,留个印象。后面的模板部分如果同学们觉得难以理解也不必担心,这里仅作学习参考,不做强制要求
- 内存与对象模型:栈与堆、对象生命周期、指针所有权、悬空指针、越界访问、内存泄漏、未定义行为。
- RAII 与智能指针:理解资源获取即初始化,掌握
std::unique_ptr、std::shared_ptr、std::weak_ptr的所有权关系,知道循环引用和不必要的共享所有权为什么会造成问题。 - 移动构造、移动赋值、拷贝构造、拷贝赋值、
std::move、右值引用、万能引用、完美转发 constexpr、结构化绑定、autonullptr、std::optional、std::variantstd::string_view,以及字符串视图与对象生命周期之间的关系。- 面向对象:继承、多态、虚函数、纯虚函数、虚析构函数、接口类、对象切片、Lambda、Functor。
- 模板与泛型:函数模板、类模板、模板参数、模板特化、偏特化、非类型模板参数、参数包、折叠表达式、
decltype和type_traits。 - 模板元编程:理解 SFINAE、
std::enable_if、CRTP、Concepts、requires、Mixin。
ROS 2
ROS 2 的核心是把机器人拆成彼此协作的节点:传感器节点发布数据,定位节点估计状态,规划节点产生路径,控制节点执行运动。
基础部分
- 工作空间与功能包:理解
src、build、install、log目录,了解package.xml、setup.py/setup.cfg和CMakeLists.txt在功能包中的分工。 - 节点:使用
rclpy或rclcpp创建 Node,掌握节点名称、命名空间、日志、参数和生命周期的基本使用。 - Topic:理解 Publisher、Subscription、消息类型、队列深度、回调函数和消息时间戳;学习使用
ros2 topic list、ros2 topic info、ros2 topic echo、ros2 topic hz等查看通信状态。 - Service 与 Action
- 了解
std_msgs、geometry_msgs、nav_msgs、sensor_msgs中常见消息的字段。 - 参数与启动:使用Launch 文件组织多个节点,理解参数声明、默认值、命名空间和 Topic remap。
- RViz:显示 RobotModel、TF、LaserScan、PointCloud、Map、Path、Odometry,熟悉 Fixed Frame、显示坐标系、时间和话题配置。
- TF:理解坐标树、父子坐标系、静态变换和动态变换,掌握
map、odom、base_link以及激光或相机坐标系的作用。
算法前置知识
阅读本文需要部分线性代数基础,最起码需要理解矩阵、矩阵乘法、矩阵的逆、矩阵的转置、矩阵的秩、行列式、正交矩阵、和反对称矩阵
没有学过线性代数的同学可以看 3Blue1Brown 快速入门线代,传送门:Essence of linear algebra 汉语配音
Chapter 1 · 位姿表达
在平面直角坐标系中,假设有 A B 两个点。如何从 A 点到 B 点?想要分析这个问题,第一步当然是先把 A 和 B 各自先表示出来。想要实现机器人的导航,第一步是想办法描述机器人当前的位姿(位置与姿态),位置可以类比前面提到的坐标系中的坐标,而姿态则可以先理解成是机器人当前面朝的方向。本章我们将了解如何表达机器人的位姿。
1.1 叉乘
对于 和 ,叉乘定义为
三维向量叉乘的结果仍是三维向量,并且同时垂直于 和 ,其方向由右手定则确定,模长满足
其中 是两个向量的夹角。
叉乘具有反交换性:
对于三维向量,定义 hat():
得到一个三维反对称矩阵,可以看出,
因此,叉乘可以写成一个反对称矩阵与向量的乘法。反过来,对于任意三维反对称矩阵
vee() 定义为
它把反对称矩阵恢复成对应的向量。于是有 ,以及 (后一个等式要求 确实是反对称矩阵)。
1.2 位姿表达
我们的机器人除了位置移动,还能够旋转,因此需要同时表示位置和朝向。二维位姿可写成,其中 是位置, 是绕竖直轴的航向角。
而三维位姿通常写成
其中 表示旋转, 表示平移。
1.3 旋转矩阵和旋转向量
若方阵 满足
则称其为三维旋转矩阵,记作 。 , 所以旋转矩阵是行列式为1的正交矩阵,因此旋转矩阵也满足正交矩阵的一些性质:
- 所有行向量/列向量都两两正交
- 两个正交矩阵的乘积仍然是正交矩阵,正交矩阵的转置、逆矩阵仍然是正交矩阵
- 正交变换不改变两个向量的内积、向量之间的角度或向量的长度
旋转向量(轴角)用 表示, 是单位旋转轴, 是旋转角。
罗德里格斯公式:
该公式可以将三维空间中绕任意单位轴旋转某个角度转化成矩阵表示。
反过来,也可以从旋转矩阵恢复轴角:
注意,这个公式在 和 时会失效,感兴趣的同学可以自行搜索解决方案。
1.4 欧拉角
欧拉角把旋转拆成三个有顺序的轴旋转,例如 ZYX 约定为 yaw-pitch-roll:由于矩阵乘法不具有交换律,所以旋转轴的顺序会影响旋转的最终结果。
但是欧拉角旋转有个问题,就是当俯仰角接近 时,会出现万向节锁,导致后一次旋转和前面某次旋转的转轴重合。使用四元数描述旋转可以解决这个问题。
1.5 万向节锁
万向节锁(gimbal lock)并非云台真的锁住无法旋转,而是欧拉角这组三个参数在某些姿态下失去了一个独立自由度。仍然以常见的 ZYX(yaw-pitch-roll)顺序为例:
其中 是偏航角, 是俯仰角, 是滚转角。展开矩阵可得
为避免矩阵过宽,记
当 时,,矩阵变为
很容易看出,此时矩阵只依赖 ,而不再分别依赖 和 。例如, 与 产生了相同的旋转,yaw 和 roll 已经无法区分。
1.6 四元数
四元数可以看作一个实部和三个虚部组成的数:
其中 。例如,绕 轴旋转 可表示为
对于单位四元数,满足
单位四元数用四个数表示三维旋转,但因为有单位长度约束,实际只有三个独立自由度。
四元数的共轭为
四元数的逆为
与旋转矩阵乘法类似,四元数的乘法表示将两个旋转合并成一个旋转。若 ,则
若 表示把 坐标系中的向量旋转到 坐标系,连续变换的复合为
四元数乘法不满足交换律。
四元数与旋转对应,但是想要通过四元数来得到我们想要的旋转,首先就要把旋转变成四元数表示。若旋转轴为单位向量 ,旋转角为 ,则对应的单位四元数为
反过来,对于 ,可以计算
当 不为零时,旋转轴为
由于 和 表示同一个旋转,实际中常先约定 。
把三维点/向量 写成纯虚四元数 。用 表示旋转时,旋转后的向量为
取结果的向量部分即可得到 。对应的旋转矩阵为
Chapter 2 · 位姿估计
第一章中,我们已经学习了怎样表示位置和旋转。给定出一个旋转矩阵或者四元数,就可以描述机器人的朝向,再加上平移,就可以描述机器人的完整位姿。
要想表示机器人的位姿,就得先得到机器人的位姿,然而,大多数情况中,机器人并没有上帝视角,无法直接获取到自己的位姿
为了得到机器人的位姿,我们需要着手处理各种传感器得到的环境信息。但是,激光雷达测得的是点云数据,IMU 测得的是角速度和加速度,里程计提供的是位移信息……这些数据不仅形式不同,还带有误差,每一个传感器误差的大小、分布甚至会天差地别。即使同一个传感器描述同一个机器人运动,给出的结果也可能会有很大差异。
那么,如何才能尽可能排除噪声的干扰,在混乱中找到合理的估计?这就是这一章节我们要讨论的。
2.1 一些基础知识
2.1.1 优化问题
位姿的估计可以看作是一个优化问题:根据当前观测找到最优的估计。 一个优化问题通常写成
其中 是优化变量, 是目标函数或代价函数, 是由约束决定的可行域。约束常写成 和 ,可行域是满足全部约束的点集。无约束问题取 ;等式、不等式和边界条件都会缩小可行域。使目标函数达到最小的变量写作
举个例子: 假设一家工厂生产某种商品:
- 每件商品售价为 50 元。
- 每天生产 件商品的总成本为 元。
- 工厂每天最多生产 30 件商品。
问题:工厂每天生产多少件商品,才能获得最大利润?
设工厂每天生产 件商品, 利润等于销售收入减去生产成本:
我们的目标是使利润最大。
因为工厂每天最多生产 30 件商品,且生产数量必须为非负整数,所以:
所以该优化问题为:
利用高中学过的配方法:
因为 ,所以当 时,目标函数最小, 也就是说 此时,工厂利润为
2.1.2 导数与梯度
一元函数的导数描述输入发生微小变化时输出的变化率:
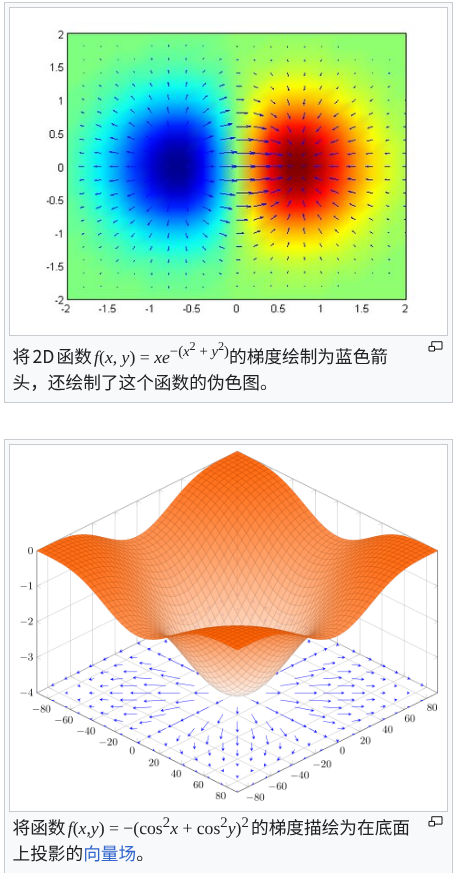
对标量函数 ,梯度定义为一阶偏导组成的列向量
梯度的方向是当前点函数值增长最快的方向。
2.1.3 雅可比矩阵与海森矩阵
对向量函数 ,雅可比矩阵是一阶偏导组成的矩阵:
雅可比矩阵的行描述了一个输出分量受哪些输入影响,列描述了一个输入分量对全部输出的影响。
雅可比矩阵给出局部线性映射:
标量函数()的雅可比矩阵是梯度的转置:。
复合函数的雅可比遵循链式法则:。
海森矩阵是二阶偏导组成的矩阵,或者说,是梯度的雅可比矩阵。
2.2 状态、观测和模型
2.2.1 状态与观测
假设一个机器人沿直线运动,我们希望描述它的运动状态。能够表征运动状态的一组变量称为状态。将这些变量组成向量,称为状态向量,记为
传感器实际获得的测量数据称为观测。如果共有 个观测量,将它们组成观测向量
例如,假设机器人前方有一面位置已知的墙,墙的位置为 ,机器人位于墙的左侧。若机器人位置为 ,则理想情况下有
传感器观测的就是这个距离 。
我们用函数 描述状态到理想观测之间的函数关系。考虑测量误差后,观测模型写为
其中, 为观测噪声,且
对于前面的测距例子,
因此实际观测模型为
观测可以提供关于状态的信息,从而帮助我们估计和修正状态。
2.2.2 残差与最小二乘
假设我们有状态估计 ,根据观测模型,状态 对应的预测观测为 ,而传感器实际得到的观测为 。在本章的优化部分,我们将二者之差定义为残差 :
残差反映了预测观测与实际观测之间的偏差。残差越接近零,说明当前状态与观测越一致。
可以借助下面的例子辅助理解: 考虑一个做匀加速直线运动的机器人。设初始位置和初始速度分别为 和 ,加速度 已知且保持不变。取状态向量为
经过时间 后,机器人的位置
如果传感器测量机器人在时刻 的位置,那么第 次观测的预测值为
例如,设加速度为 ,当前状态估计为
在 时,根据这一状态预测得到的位置为 。如果实际位置 ,则残差为
在 、、 和 四个时刻,假设传感器分别测得位置
对于第 次观测,残差为
将所有残差组成残差向量:
由于存在测量噪声,一般无法找到一个状态,使所有残差同时等于零。因此,我们不再要求状态严格满足每一个观测方程,而是希望找到一个与所有观测整体上尽可能一致,即使得残差整体最小的状态。
最常用的方法,是使残差平方和最小,这就是最小二乘法。定义函数
目标函数前的系数 是为了使后续求导的形式更加简洁。其中, 称为目标函数或代价函数。最小二乘估计就是求解
使用平方有如下好处:
- 平方可以保证非负,防止求和时出现负值与积累的残差相互抵消
- 残差越大,其平方增长越快,因此较大的残差会对目标函数产生更大的影响。
有些资料将残差定义为观测减预测: 两种定义只相差一个负号,因此对于平方和形式的最小二乘问题, 不会发生变化。但是,残差的雅可比矩阵也会随残差定义整体改变符号,因此本文统一采用 即“预测减观测”。
2.2.3 方差与协方差
前面的最小二乘目标函数为
这种方式对所有残差采用相同的权重,隐含了“所有测量同等可靠”的假设。然而,实际测量总是伴随着噪声。我们通过方差来量化这种测量不确定性:
其中 是噪声。 是数学期望,可以理解为大量重复实验下的平均值。方差越大,说明测量值围绕其均值的波动越剧烈,测量的不确定性也就越高。方差的平方根 称为标准差。
对于同一个传感器,如果测量时间较短且工作条件基本不变,通常可以认为它的噪声统计特性保持稳定。此时,我们可以假设各次测量噪声具有相同的方差 。
对于向量噪声 ,由于各个分量之间也存在相互之间的联系,我们采用协方差来衡量随机变量间的相关程度:
由此我们可以写出 的协方差矩阵:
若 为零均值,则
举个栗子,对于二维噪声
其协方差矩阵可以写成
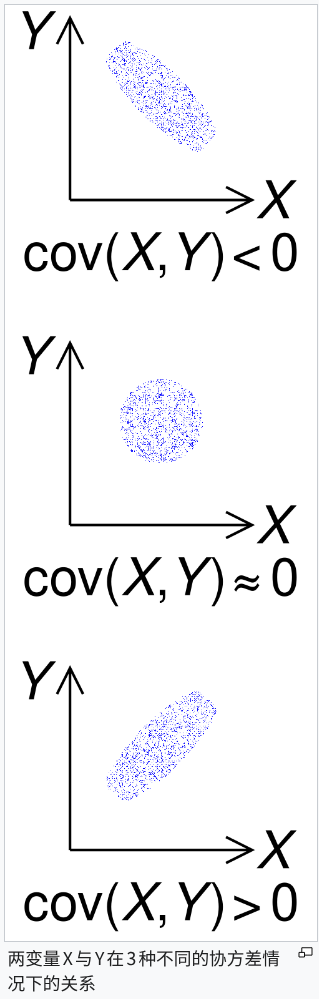
对角线上的 和 (分别简记为 和 )表示两个噪声分量自身的方差 非对角线上的 (简记为 )表示两个噪声分量之间的协方差。
如果 ,两个误差分量具有同向变化的趋势 如果 ,则具有反向变化的趋势 如果 ,则称二者不相关。
各位应该还记得高中学的相关系数吧?
细心的朋友可能已经发现了,分子部分其实就是协方差求和,分母部分就是标准差的乘积!高中我们学过柯西不等式:
即
等号当且仅当
时成立。如果将两边同时开平方,就可以得到:
如果再将 换成 , 换成 ,就能得到相关系数了。高中我们学过,相关系数的绝对值越接近 1, 表示线性相关性越强;越接近0, 线性相关性越弱,由此我么可以看出相关系数和协方差之间的一些联系。
2.2.4 加权最小二乘
如果所有观测具有相同的噪声方差,那么普通最小二乘就足以得到最优的状态估计。
但是,在实际系统中,不同传感器或者不同观测分量的测量精度可能不同。
例如,一个传感器的精度可能是 , 另一个可能是 ,显然后者精度更高,误差更小,也就应该有更高的权重。
回顾上一小节中相关系数的公式:
这个公式的核心操作是除以标准差。为什么要这样做?因为 和 可能波动幅度各不相同。除以标准差,可以消除自身波动幅度的影响
对于最小二乘,我们也可以执行同样的“标准化”操作。对于第 个观测分量,我们除以其噪声的标准差 :
标准化后的 表示“当前残差相当于几个噪声的标准差”。对归一化残差的平方求和,就得到了加权最小二乘的目标函数:
实际上,这里除以测量噪声的标准差,并非仅仅出于直觉,而是可以在噪声满足高斯分布的假设下,利用最大似然估计推导出来的,感兴趣的同学可以自行搜索相关推导。
2.3 最小二乘的求解
前面我们已经知道如何根据测量噪声构造目标函数。接下来要解决的问题是:如何找到使目标函数最小的状态估计值?
2.3.1 线性最小二乘
2.3.1.1 正规方程
我们知道,单个观测的残差可以表示为预测值与观测值之差:
其中 为第 个观测的预测值。对于本节讨论的线性最小二乘问题,观测模型是线性的,即 ,因此把所有观测的残差放在一起,可以写成方程方程组:
于是可以得到残差向量的矩阵表式:
代入加权最小二乘目标函数,可以去掉求和符号,得到:
其中,。将展开:
注意,中间的两项 和 实际上都是标量( 的矩阵),所以转置后不变:
又因为 是对称矩阵,所以,
这说明中间两项是完全相等的,可以合并:
将合并后的结果代回,得到最终的矩阵展开形式:
其中,第一项与 无关,第二项是关于 的线性项,第三项是二次项。
对 求梯度:
令梯度为零,并将对应的状态估计记为 ,便可得到:
这就是加权最小二乘的正规方程。如果没有加权,令 ,正规方程变为:
对应的普通最小二乘解为:
2.3.1.2 梯度下降法
梯度下降法,顾名思义就是利用梯度使目标函数的值下降到方法。简单概括可以理解成:从一个初始估计出发,不断调整状态,使目标函数逐步减小,最终逼近最优解。仍然考虑加权最小二乘目标函数:
上一节我们推导了,它的梯度为:
梯度指向了目标函数增长最快的方向。因此,为了减小目标函数,我们可以沿着与梯度相反的方向,即负梯度方向更新状态。将第 次迭代的状态估计记为 ,该位置的梯度记为:
对于一个较小的状态增量 ,我们可以近似看作:
将上述状态增量加到当前估计上,得到梯度下降法的一般迭代公式:
其中 用于控制变化的快慢,我们称其为学习率。随着一步步迭代,我们的目标函数值会逐渐下降,我们的状态也将不断向目标函数的极小值点逼近。代入加权最小二乘目标函数的梯度,得到:
这就是线性加权最小二乘问题的梯度下降迭代公式。如果没有加权,令 ,迭代公式便退化为:
如果学习率过小,每次更新带来的变化很小,通常需要较多次迭代才能接近最优解;如果学习率过大,则可能越过目标函数较小的区域,导致难以收敛。因此,学习率的选择直接影响梯度下降法的收敛性和收敛速度。
首先,对于本节的线性最小二乘问题,目标函数是关于 的二次函数。回顾其一阶梯度为 。对其再次求导,常数项 导数为零,线性项的导数即为其系数矩阵。因此,目标函数的二阶导数矩阵,也就是海森矩阵,为:
接下来,我们分析误差的迭代过程。设第 次迭代的误差为 ,其中 是真实的最小二乘解。
将梯度下降的更新公式 展开:
等式两边同时减去最优解 ,并利用 进行替换,得到误差的递推关系:
我们令矩阵 ,则公式可以简写为:
我们将这个递推关系不断向前展开:
我们要让误差 在 时最终变成 ,也就是矩阵 的 次幂 在 时,必须收敛为零矩阵。
直接求 的 次方并不好求,所以我们需要适当的变形。因为海森矩阵是对称矩阵,所以 也是对称矩阵。对称矩阵一定可以被正交对角化,即:
其中:
- 是由 的特征向量组成的矩阵。
- 是对角矩阵,对角线上的元素就是 的特征值 。
现在,我们可以这样计算 的 次幂:
注意中间的 。因为 是对角矩阵,它的 次幂极其简单,只需要把对角线上的每个特征值分别求 次方:
在实数范围内,一个数 的 次方 当 时趋于 0 的充要条件是:
为了让 趋于零矩阵,进而让 趋于零矩阵,矩阵 的每一个特征值 的绝对值都必须严格小于 1。我们令 为海森矩阵的特征值,也就得到:
把绝对值展开:
各项同时减去 1:
各项同时乘以 -1:
由于 ,解得:
为了使该条件对所有特征值都成立,我们直接取最大的特征值。因此,如果采用固定步长,即 ,并满足:
那么梯度下降法便能从任意初始值收敛到唯一的最小二乘解。其中,表示海森矩阵的最大特征值。在上述学习率范围内,只要当前梯度不为零,每次迭代都会使目标函数减小。
以下是梯度下降法的大体步骤:
- 初始化。 选取初始估计 ,设置步长、收敛阈值 和最大迭代次数。初始估计可以取零向量,也可以根据已有信息给出。
- 计算残差和梯度。 在第 次迭代中,计算:
- 检查停止条件。 如果梯度的范数已经足够小,即:
则停止迭代,将当前的 作为最小二乘解的近似值。 4. 更新状态。 如果尚未满足停止条件,则按照:
2.3.2 非线性最小二乘
线性最小二乘要求残差能够写成 的仿射形式。然而,当残差中包含距离、旋转、乘积或其他非线性运算时,就无法通过一个固定矩阵一次性描述整个问题。例如,仍考虑二维平面上的地标测距。机器人的位置为 ,第 个地标的位置为 。传感器测量机器人到每个地标的距离,测量值为 。现在我们想要估计根据传感器的测量信息估计机器人当前的位置,预测距离和残差分别为:
可以看到,状态的两个分量在平方根下面,不能直接写成固定矩阵乘状态的形式。如何解决?我们采用非线性优化的核心思想:局部线性化。
2.3.2.1 局部线性化
假设在第 次迭代时,我们有一个当前的状态估计 。为了在 附近近似非线性残差,我们将其在当前点展开为关于 的一阶泰勒多项式:
其中, 是残差向量在当前点的雅可比矩阵。至此,我们完成了对当前非线性状态的线性化。这种线性化只在 附近生效,我们接下来就需要在这附近构造一个近似模型,寻找极值点。
2.3.2.2 高斯-牛顿法
高斯-牛顿法可以理解成:在当前点 处,利用一阶雅可比矩阵构造一个与原目标函数 在该点局部相切的椭圆抛物面,并直接计算出该抛物面的最低点处的 作为下一步的迭代状态。
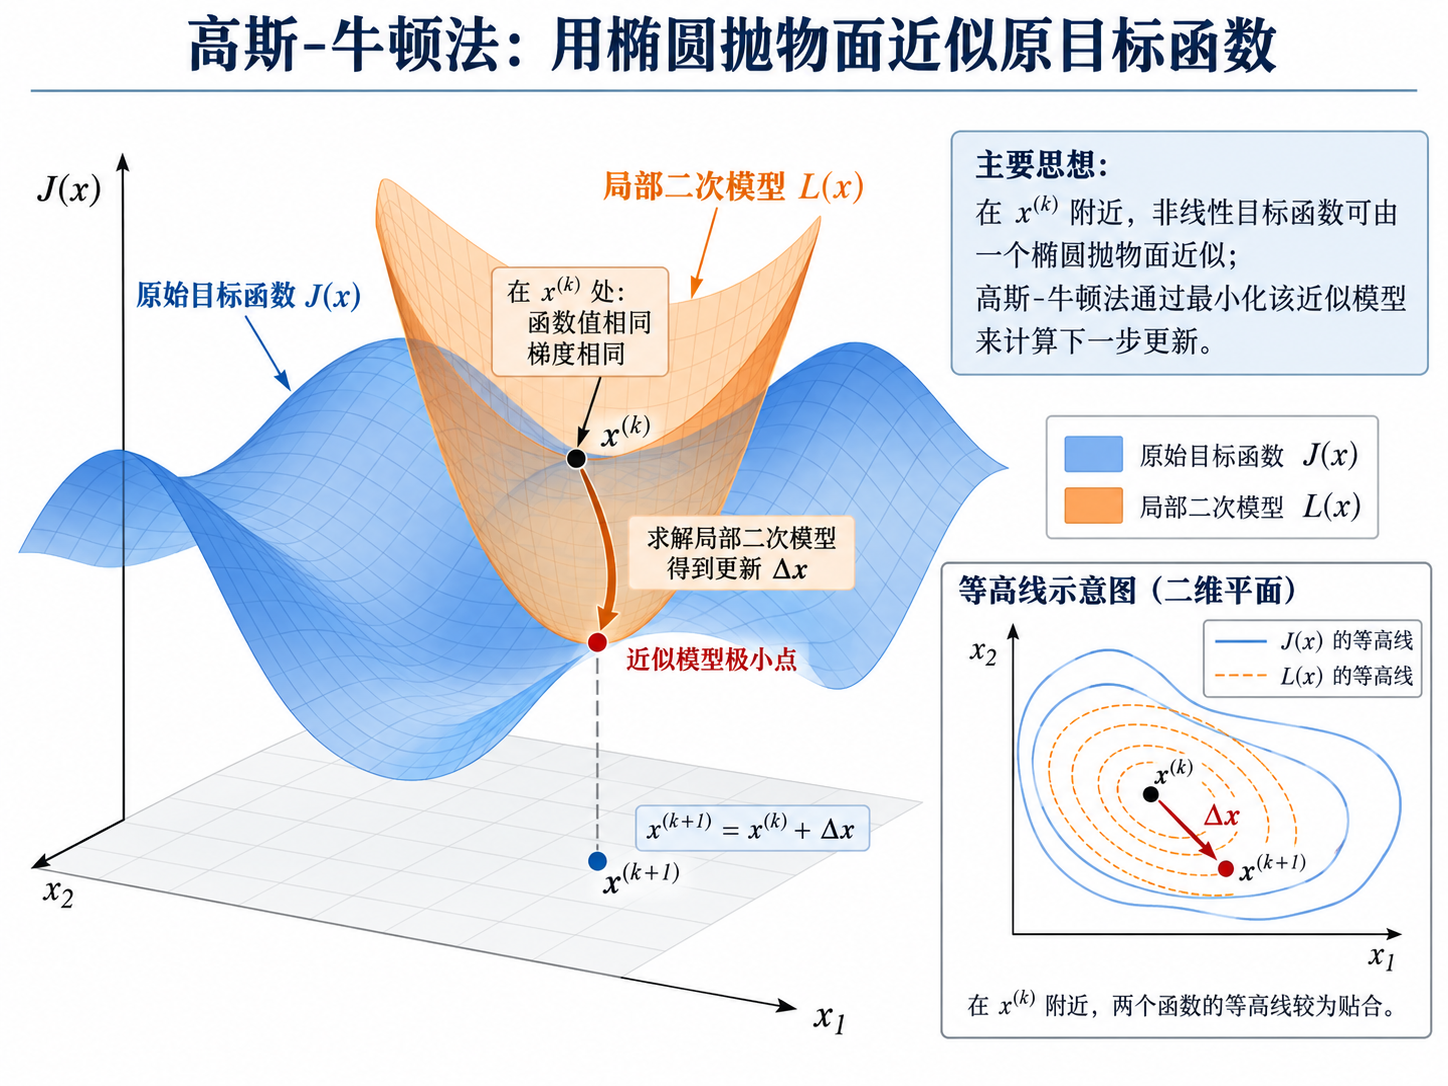
通过将上述残差向量的线性近似代入加权最小二乘目标函数 中,我们构造出一个关于 的局部二次模型,记为 :
与原函数 在 处是相切的:
- 函数值相等:当 时,括号内第二项为 ,显然 。
- 梯度相等:对 关于 求导,得到:
当 时,。而根据链式法则,原函数在该点的真实梯度 也恰好等于 。两者坡度完全一致。
既然 是一个完美的椭圆抛物面(就像一个碗),我们直接对其求导并令梯度为 ,就能找到它的最低点:
将含有 的项移到等式一边,并将该最低点定义为下一步的迭代状态 ,得到高斯-牛顿更新方程:
为了书写简洁,我们通常记近似海森矩阵(或信息矩阵) ,当前梯度 。于是方程简化为标准的线性方程组:
这样我们就可以解出 ,接下来只需要反复迭代,最终就可以求得 的估计。
高斯-牛顿法虽然好,但是存在一个问题:我们构造出的二次模型,只能在当前状态附近较好地近似原始目标函数。如果计算出的状态增量过大,下一次状态就可能超出局部线性化的有效范围。如果超出范围,即使我们找到了二次模型的最低点,原始目标函数的值也不一定减小,甚至可能增大。
如何解决这个问题?很简单,既然局部二次模型只在当前状态附近比较可靠,那么我们可以对每次更新的幅度进行限制,避免状态一次移动得太远。 列文伯格–马夸尔特法就是在高斯–牛顿法的基础上,引入一个阻尼项来实现这一思想。感兴趣的同学可以去了解一下。
2.4 卡尔曼滤波
我们之前讨论的最小二乘,主要是根据一组已有的观测,求解某个状态的最优估计。但是,机器人在不断运动,我们能利用的不仅仅是当前时刻的传感器数据,还可以利用先前的数据,借助物理模型对机器人的状态进行预估。
假设在上一时刻,我们已经估计出了机器人的位置和速度。根据运动模型,我们可以预测机器人在当前时刻的位置。与此同时,传感器也会给出一个新的位置测量。此时,我们就有了两种关于当前状态的信息: - 预测状态:基于上一时刻的状态和运动模型,预测机器人现在的位置。 - 当前观测:根据传感器的测量,获得机器人现在的位置。
显然,两者都不是完全准确的。运动模型做不到完美描述,传感器也存在噪声的影响。既然两者都存在不确定性,我们可以把预测状态也看作一种特殊的观测,再根据预测与观测各自的不确定性进行加权最小二乘,这样把预测和观测信息融合起来,就可以利用更多的信息,得到更可靠的估计。这就是卡尔曼滤波的核心。
2.4.1 预测
2.4.1.1 状态方程
假设一台机器人沿着直线运动,我们希望通过已知的运动状态和控制输入,预测机器人下一时刻的位置与速度。根据高中物理学过的直线运动公式:
只要知道机器人上一时刻的位置、速度和加速度,就可以计算这一时刻的位置和速度。
在现代控制理论中,我们希望使用统一的数学形式描述系统。为此,可以把机器人的位置和速度组合成一个状态向量:
在此基础上,我们可以将前面的两个运动学方程合并为矩阵形式:
观察矩阵形式的组成,我们可以定义: - 状态转移矩阵:
- 控制输入矩阵:
如果我们将加速度作为控制输入:
便可以得到:
其中: - :当前状态向量 - :上一时刻状态向量 - :状态转移矩阵 - :控制输入矩阵 - :控制输入
这就是离散线性状态空间模型中的状态方程。
2.4.1.2 观测方程
假设机器人安装了一个位置传感器,它只能测量机器人的位置,不能直接测量速度。理想情况下:
由于状态向量为:
因此可以写成:
定义观测矩阵:
于是得到:
这就是状态空间模型中的观测方程。 例如: - 如果传感器只测量位置,。 - 如果传感器只测量速度,。 - 如果传感器同时测量位置和速度,。
2.4.1.3 状态空间模型
综合状态方程和观测方程,可以得到:
对于真实机器人,系统运动和传感器测量通常存在随机扰动,因此进一步引入过程噪声 和观测噪声 :
状态方程: 系统根据上一时刻状态、控制输入和过程扰动,如何演化到下一时刻。 观测方程: 传感器如何从系统真实状态中获得带噪声的测量值。
过程噪声的协方差记为:
假设上一时刻,我们已经得到了最优状态估计:
此处上标的意思,下一小节会讲,暂时不需要太在意。 那么,根据运动模型,就可以预测当前时刻的状态:
这就是卡尔曼滤波的状态预测公式。但是,预测过程中也存在不确定性,一方面,上一时刻的状态估计本身就存在误差,另一方面,运动模型还引入了新的过程噪声。在过程噪声与上一时刻估计误差独立的假设下,根据前面介绍的协方差知识,可以得到预测协方差:
2.4.2 更新
首先,我们回顾一下前面讲过的加权线性最小二乘的目标函数公式:
由于现在我们现在要融合的是两组数据:预测估计和当前观测,因此我们可以把残差写成两部分: - 预测估计的残差 - 当前观测的残差 也就是:
我们把物理模型计算出的预测记为 ,其中上标 表示这是融合当前测量之前的状态估计,也称为先验估计。由于一般物理模型能够直接给出所有状态,所以观测矩阵 就是单位矩阵, 也就是:
由此得到加权最小二乘目标函数:
现在,我们已经成功将状态融合问题转化成了一个加权线性最小二乘问题。接下来我们要做的就是找到使目标函数最小的状态估计,此时的状态估计就是融合了先验估计和当前观测后的估计,我们称其为后验估计, 记作
前面我们已经推导过加权线性最小二乘的正规方程:
直接代入正规方程:
化简得到:
于是我们可以解出 :
现在还剩下权重没有确定。实际上,在噪声满足高斯分布的假设下,我们可以直接用噪声的协方差矩阵的逆来作为权重矩阵,理解方面可以参考 2.2.4 节,感兴趣的同学可以自行搜索数学推导。
具体来说,我们令先验估计的误差协方差矩阵为 ,当前传感器观测噪声协方差矩阵为 ,即:
即可得到:
但是,这个形式和常见的卡尔曼滤波的形式差别太大了,而且相当的丑,所以我们可以变形一下:
我们把 的系数矩阵移回来,为了将等式右边凑出与左边系数矩阵相关的形式,我们在等式右边同时加上并减去 :
两边同时左乘系数矩阵的逆 ,即可直接解出 :
注意等式右边的第二项,我们把 前面的系数矩阵继续改写为:
为了简化书写,我们将这个系数矩阵记为:
所以
这就是卡尔曼滤波的状态更新公式,我们把 叫做 卡尔曼增益。
回顾前面得到的正规方程:
为了简化书写,令:
定义先验估计误差为 ,后验估计误差为 。
考虑到传感器的测量模型为 ,其中 表示测量误差,将其代入正规方程并整理得到:
接下来,我们就可以直接根据这个关系计算后验误差协方差矩阵。
协方差矩阵有两个性质: - 对于误差向量 ,经过矩阵 的线性变换后,其协方差矩阵为 。 - 如果两组误差相互不相关,那么它们相加后的协方差矩阵,等于各自协方差矩阵之和。
在卡尔曼滤波中,我们假设先验估计误差与当前测量误差相互不相关,因此,根据刚才得到的后验误差表达式,可以直接计算其协方差矩阵:
由于 、 和 都是对称矩阵,因此它们的逆矩阵也具有对称性。于是,上式可以进一步化简:
将 的定义代回:
不过,这个形式与常见的卡尔曼滤波协方差更新公式仍然有所不同,因此还需要进一步化简。
由卡尔曼增益:
由于 ,因此:
最终得到:
这就是卡尔曼滤波的后验误差协方差矩阵更新公式。
2.4.3 递推
对于不断运动的机器人,每当时间从 进入 ,我们首先根据运动模型进行预测,得到:
随后,传感器给出当前观测:
我们将预测状态视为一个带有不确定性的特殊观测,与当前传感器观测一起构造加权线性最小二乘:
求解之后,得到当前时刻的最优状态估计及其协方差:
然后进入下一个时刻,将它们作为下一次预测的输入,重复整个过程。因此,我们可以将完整的卡尔曼滤波总结为两步。
第一步:预测 利用上一时刻的状态估计和运动模型,预测当前状态及其不确定性:
第二步:更新 将预测与当前观测进行加权最小二乘融合: